AI 数字人制作实操
从声音到视频的全流程
基于 GPT-SoVITS / RVC / InfiniteTalk
Tap screen to start
01. 成果展示
▶️
[此处嵌入 5 秒录音棚数字人视频]
一句话点睛
“视频 = AI 图片建模 + AI 语音 + 唇形同步技术的融合成果”
(注:背景场景由 dreamina制作 )
02. 视觉建模:大模型驱动
利用 Gemini 3 或
GPT-4o 将一张普通自拍变成专业录音棚大片。
AI 编辑实操 (In-painting)
保持角色的脸部特征、发型、服装完全不变。将背景替换为专业录音棚环境。人物在侧前方位置放置一支录音话筒,但不能遮挡人物面部。人物呈现自然的“唱歌状态”,表情放松自然,光线柔和、氛围真实。
-
场景迁移: 保持人物主体不变,一键切换至“专业演播室”。
- 光影重构: AI 自动补充轮廓光。
👆
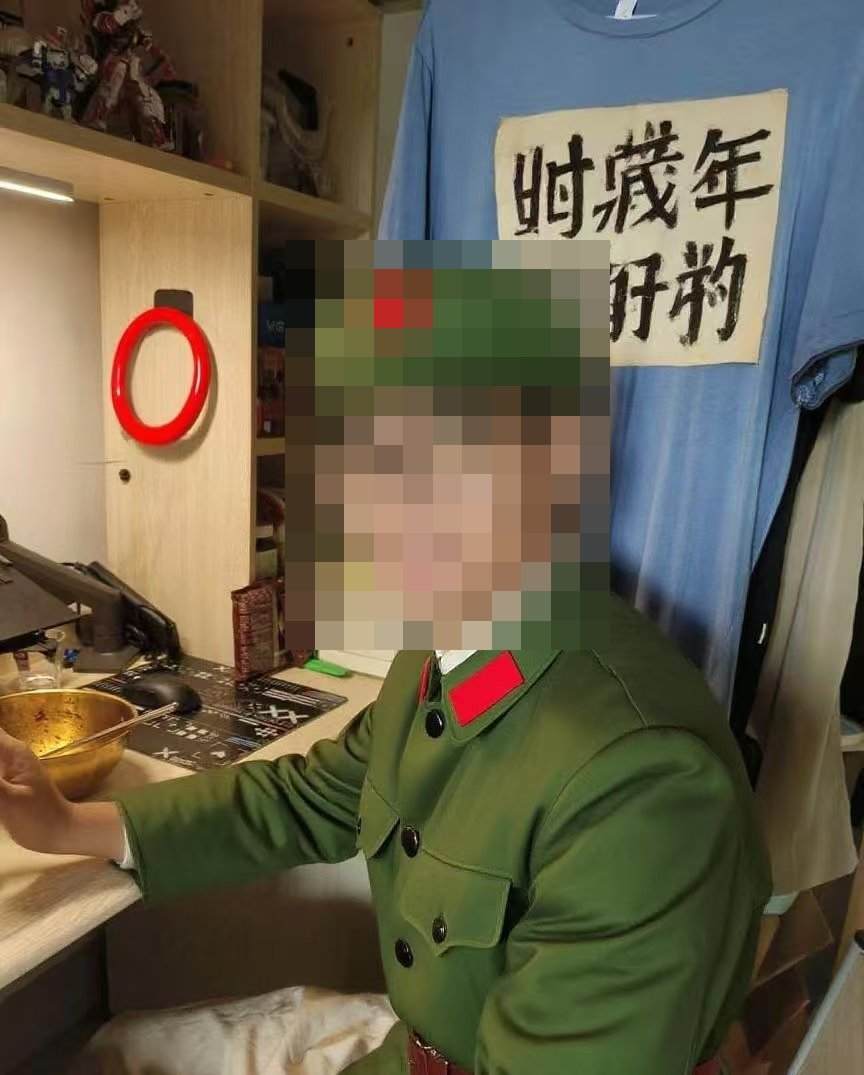
左图(手机为上图)即为初始的照片。
03. 音频生成:GPT-SoVITS
第一阶段:使用 GPT-SoVITS-v2pro 进行文本转语音 (TTS)。
核心痛点:情感“抽奖” (Lottery)
虽然它能实现零样本克隆,但模型对语气的把控具有随机性。
-
现象:
同样的文本,生成 10 次可能有 10 种不同的抑扬顿挫。
-
对策:
通过大量生成筛选出“读得通顺”的底包 (Base Audio)。
📦 View on GitHub: GPT-SoVITS
04. RVC:语气与音色注入
第二阶段:使用 RVC20240604Nvidia 进行风格迁移。
为什么必须用 RVC?
-
GPT-SoVITS 问题:
生成的底包往往声音发“干”,缺乏角色的标志性语气。
-
RVC 解决方案:
强制将底包的声线特征映射到目标模型上,把语气“模仿”出来。
📦 View on GitHub: RVC-Project
05. 视频合成:唇形同步
核心工具:InfiniteTalk (Similar to SadTalker/Wav2Lip)
技术原理
语音特征提取 → 唇形关键点映射 → 实时动画生成
核心优势
- 无需手动 K 帧 (解放生产力)
- 口型匹配度 ≥ 98%
📦 View on GitHub: InfiniteTalk
06. 视频技术标注
Pipeline 简介:
这是一个串联式的工作流。点击下方模块可查看详情。
Layer 1: 背景 (Background)
AI 图片编辑技术 (Gemini/GPT)
Layer 2: 声音 (Audio)
GPT-SoVITS (骨架) + RVC (灵魂)
Layer 3: 口型 (Lipsync)
InfiniteTalk 实时匹配
07. 技术难点与试听
实操中常遇到的问题与解决办法:
Case 1: RVC唱歌的难点
❌ 失败:歌词的音调过高,样本里没有对应的音调。
✅ 成功:不唱歌也是一种选择
Case 2: 唇形对位
- 问题: 采样率不匹配导致音画不同步。
- 方法: 换一种对嘴型的算法。
08. 效能价值对比
传统制作流 vs. 本案 AI 工作流:
A:传统制作 (高成本)
- 场景建模: 2 小时
- 录音: 重录 10+ 次
- 唇形: 手动 K 帧 1 天
B:AI 工具制作 (高效率)
- AI 生成: 30 秒
- 录音: 5 秒克隆,一次生成
- 唇形: 实时自动匹配
09. 未来展望:从视频到生命
当前的视频生成只是第一步,未来的核心在于“实时交互”。
1. 接入 LLM (大语言模型)
将写好的剧本替换为 ChatGPT/Claude 的 API 接口。
-> 赋予数字人“大脑”,实现实时问答。
2. 极低延迟推理
优化 RVC 和 InfiniteTalk 的流式推理速度 (Streaming)。
-> 将“生成视频”变为“在线视频通话”。
终极形态
24小时在线的 AI 伴侣 / 客服 / 讲师
永远有情绪,永远秒回,永远在线。